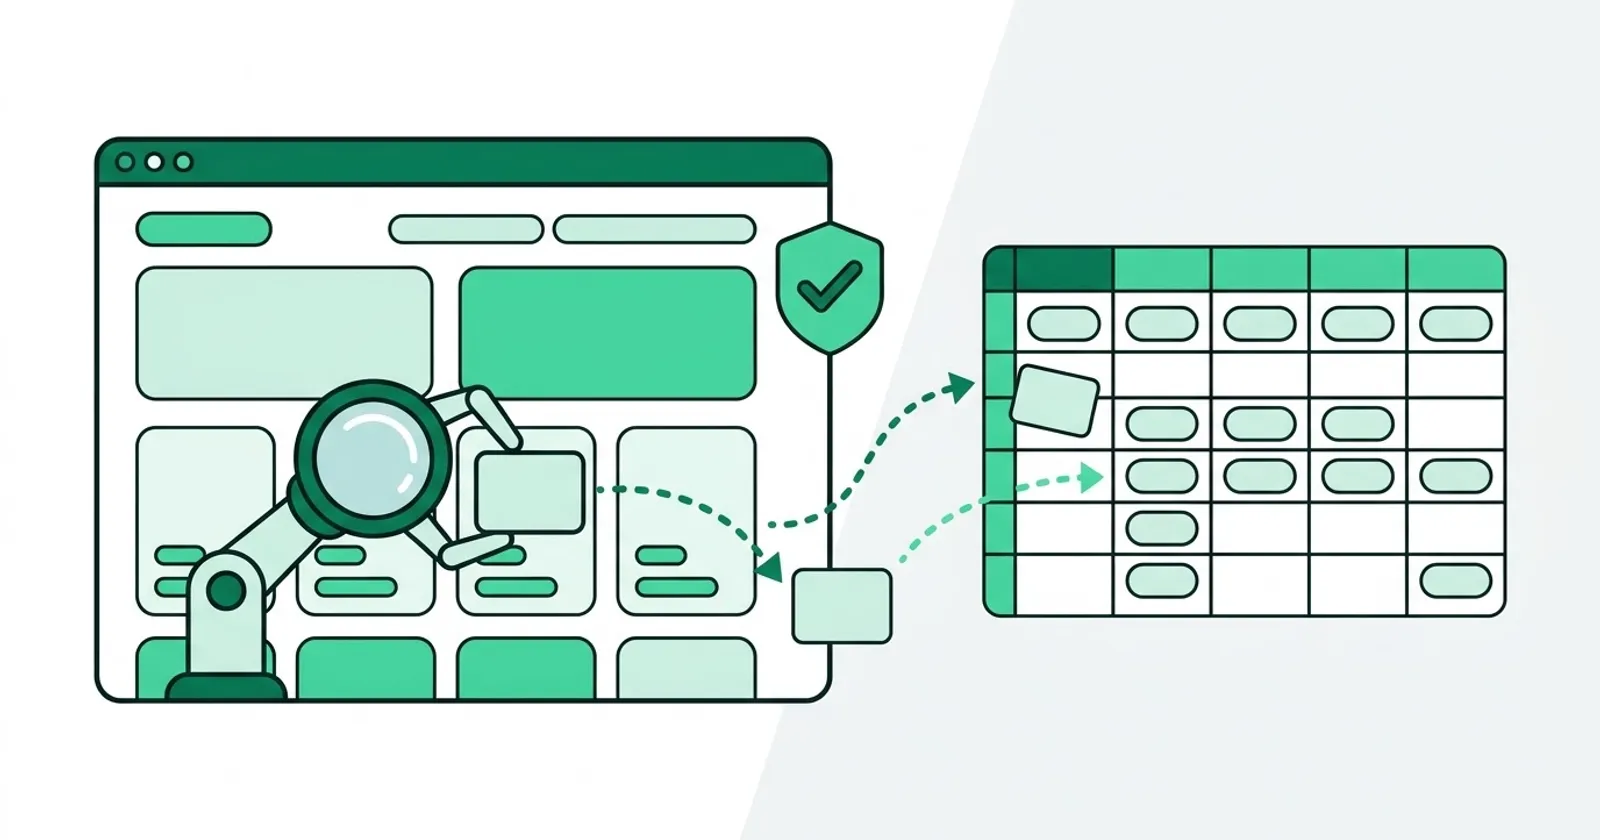
Apa itu web scraping? Singkatnya, web scraping adalah pengambilan data dari website secara otomatis memakai program. Program mengunduh halaman, membaca strukturnya, mengambil bagian yang dibutuhkan seperti nama produk, harga, atau alamat, lalu menyimpannya ke lembar kerja atau basis data.
Bagi pemilik usaha, istilah ini muncul dari dua sisi. Di satu sisi, scraping bisa membantu riset pasar dan memantau harga pesaing. Di sisi lain, website Anda sendiri bisa menjadi sasaran scraper yang membebani server atau menyalin isi halaman. Artikel ini menjelaskan cara kerja web scraping, contoh pemakaiannya, batas etika dan hukumnya di Indonesia, serta cara melindungi website Anda.
Pengertian web scraping
Wikipedia mendefinisikan web scraping, juga disebut web harvesting atau web data extraction, sebagai bentuk pengambilan data dari website. Prosesnya bisa dilakukan manual oleh manusia, tetapi istilah ini umumnya merujuk pada proses otomatis yang dijalankan bot atau web crawler. Hasilnya adalah salinan data tertentu yang disimpan ke basis data atau lembar kerja untuk dianalisis kemudian.
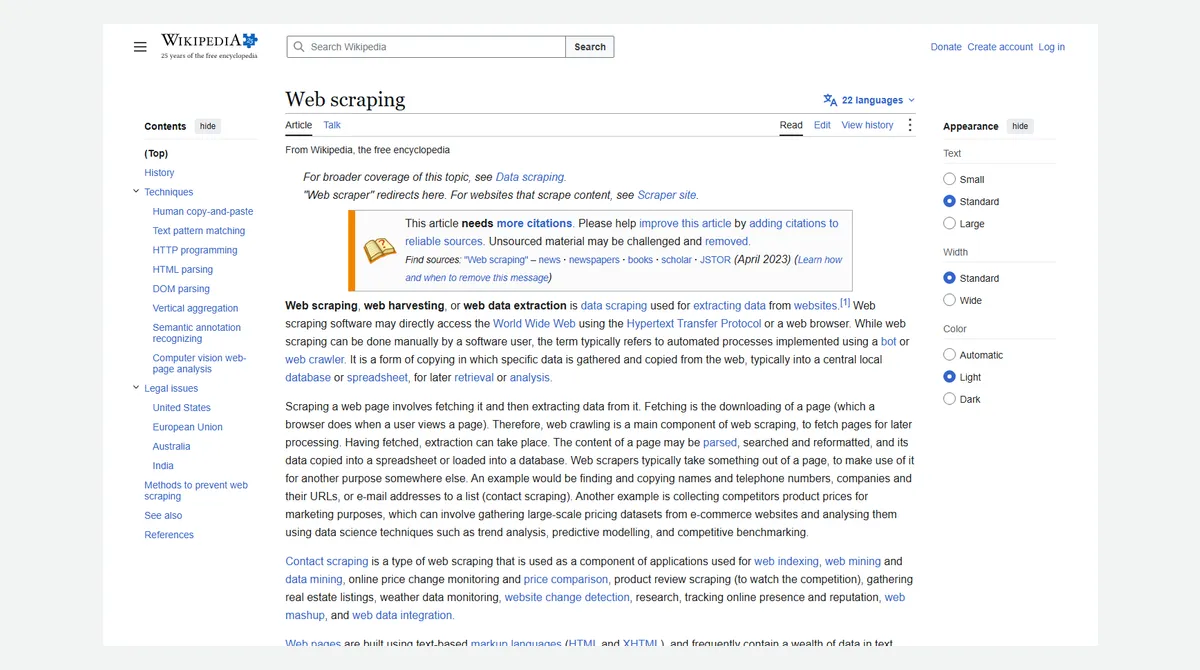
Cara paling sederhana sebenarnya menyalin dan menempel data dari halaman ke lembar kerja secara manual. Cara ini tidak butuh alat apa pun, tetapi lambat dan rawan salah kalau datanya banyak. Karena itu, kebanyakan orang memakai program agar pekerjaan yang sama bisa dilakukan ribuan kali dalam waktu singkat.
Web scraping bekerja di atas fondasi yang sama dengan website biasa. Program meminta halaman lewat protokol HTTP, persis seperti browser saat Anda membuka sebuah alamat. Kalau istilah ini masih asing, baca dulu protokol yang dipakai untuk mengakses halaman web dan anatomi link website.
Cara kerja web scraping
Wikipedia membagi scraping halaman menjadi dua langkah besar: mengambil (fetching) dan mengekstrak (extraction). Mengambil berarti mengunduh halaman, sama seperti yang dilakukan browser saat Anda melihat sebuah halaman. Setelah halaman terunduh, isinya diurai, dicari, dan disusun ulang, lalu datanya disalin ke lembar kerja atau basis data.
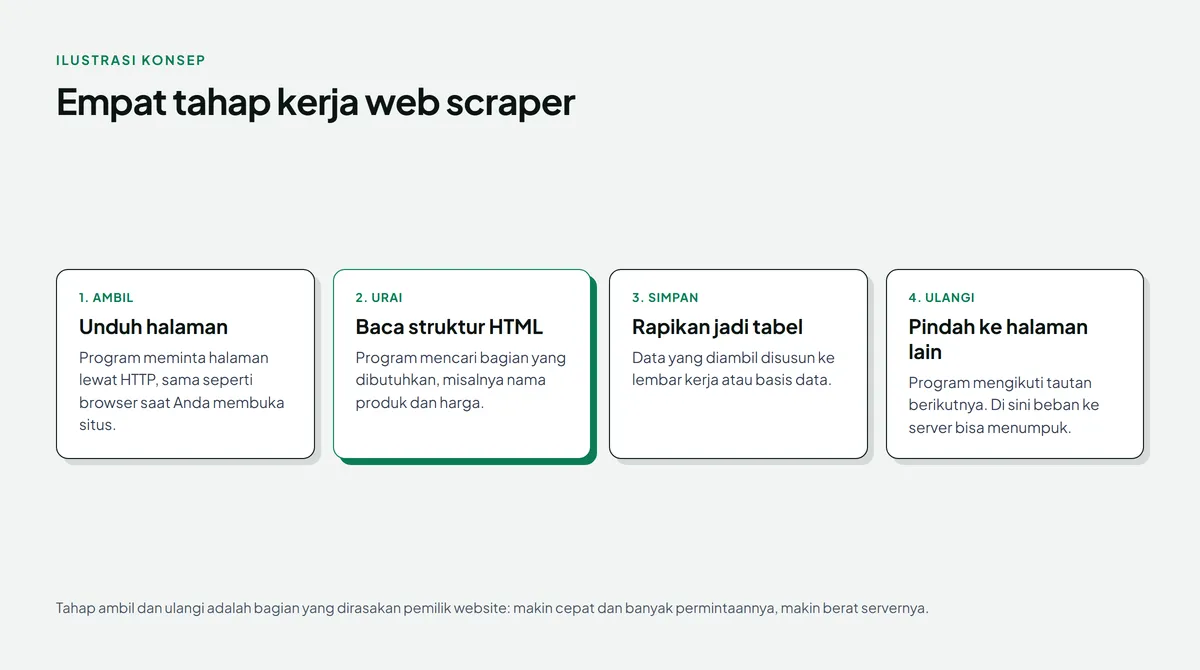
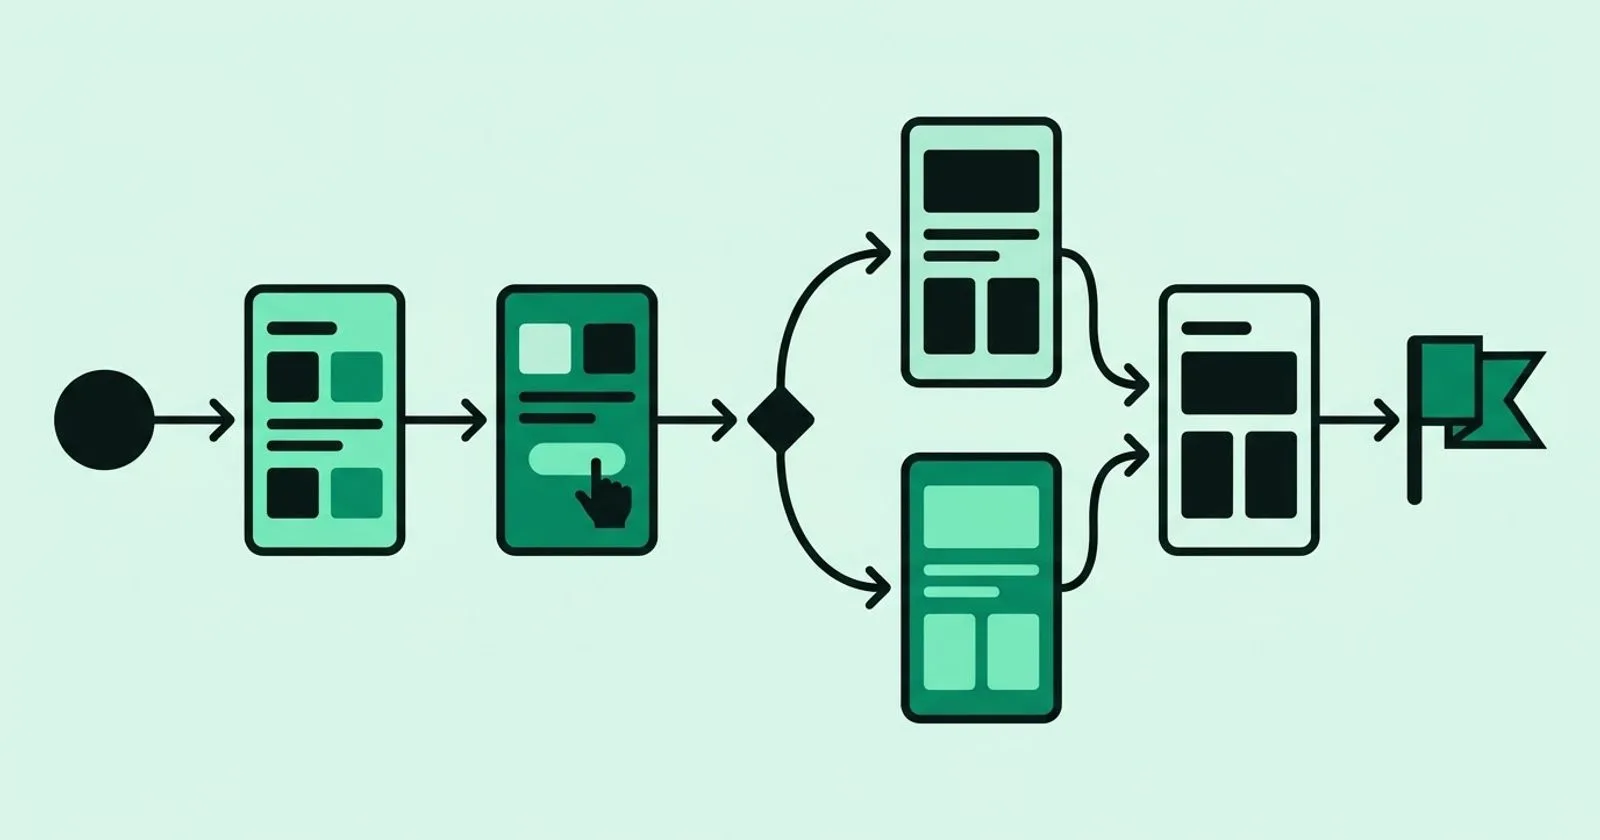
Secara lebih rinci, alurnya biasanya seperti ini:
- Menentukan target. Pembuat scraper memilih halaman dan data yang ingin diambil, misalnya daftar produk di sebuah kategori.
- Mengunduh halaman. Program mengirim permintaan HTTP ke server dan menerima kode HTML halaman.
- Mengurai struktur. Program membaca HTML dan mencari elemen tertentu, misalnya teks di dalam kelas judul produk atau harga.
- Menyimpan data. Data yang ditemukan disusun ke kolom lembar kerja atau tabel basis data.
- Mengikuti tautan. Program pindah ke halaman berikutnya, misalnya halaman 2 dari daftar produk, lalu mengulang prosesnya.
Untuk situs yang isinya dimuat lewat JavaScript, scraper sederhana kadang hanya mendapat halaman kosong. Wikipedia mencatat bahwa pengembang bisa memakai program seperti Selenium atau Playwright untuk mengendalikan browser sungguhan, memuat halaman sampai lengkap, lalu membaca strukturnya. Ada juga alat tanpa kode dengan antarmuka visual untuk menandai data yang ingin diambil.
Web scraping, web crawling, dan API
Tiga istilah ini sering tertukar. Ketiganya sama-sama cara program mengakses data dari web, tetapi tujuan dan caranya berbeda. Wikipedia menyebut crawling sebagai komponen utama scraping, karena halaman harus diambil dulu sebelum datanya diekstrak. Sementara itu, API adalah pintu resmi yang sengaja disediakan pemilik layanan.
Tabel ini lebih lebar dari layar. Geser ke samping untuk melihat seluruh kolom.
| Aspek | Web scraping | Web crawling | API |
|---|---|---|---|
| Tujuan utama | Mengambil data tertentu dari halaman | Menjelajah dan mengunduh banyak halaman | Bertukar data lewat jalur resmi |
| Contoh pelaku | Alat pemantau harga, riset pasar | Crawler mesin pencari | Aplikasi yang memakai data layanan lain |
| Bentuk data yang diterima | HTML yang harus diurai | HTML dan berkas lain | Data terstruktur, biasanya JSON |
| Izin pemilik situs | Sering tidak diminta | Diatur lewat robots.txt | Diberikan lewat kunci akses dan syarat pemakaian |
| Kestabilan | Mudah rusak saat tampilan situs berubah | Tergantung struktur tautan | Stabil selama versi API tidak berubah |
Wikipedia mencatat bahwa pada tahun 2000, Salesforce dan eBay meluncurkan API mereka sendiri, sehingga pemrogram bisa mengakses sebagian data publik secara resmi. Sejak itu, banyak situs menyediakan API. Kalau sebuah layanan punya API, jalur ini hampir selalu lebih baik daripada scraping karena lebih stabil dan jelas izinnya. Penjelasan dasar tentang pertukaran data antaraplikasi ada di artikel web service adalah.
Contoh pemakaian web scraping untuk usaha
Wikipedia menyebut sejumlah pemakaian web scraping, di antaranya pemantauan perubahan harga dan perbandingan harga, pengumpulan ulasan produk untuk memantau persaingan, pengumpulan daftar properti, pemantauan data cuaca, deteksi perubahan website, riset, serta pemantauan reputasi online. Berikut gambaran penerapannya untuk usaha di Indonesia.
- Memantau harga pesaing. Toko online mencatat harga produk serupa di beberapa situs untuk menentukan harga jual. Kalau Anda sedang menyiapkan toko sendiri, baca cara membuat toko online.
- Mengumpulkan ulasan. Tim produk merangkum keluhan yang sering muncul di ulasan publik untuk memperbaiki layanan.
- Memantau perubahan halaman. Bagian legal atau pemasaran diberi tahu saat halaman tertentu, misalnya syarat layanan mitra, berubah.
- Riset pasar. Mengumpulkan daftar produk di satu kategori untuk melihat rentang harga dan fitur yang umum.
- Memeriksa website sendiri. Alat audit SEO pada dasarnya merayapi website Anda untuk mencari tautan rusak, judul ganda, atau halaman tanpa deskripsi. Contoh pemeriksaan seperti ini ada di checklist website siap SEO.
Jenis alat yang dipakai untuk scraping
Wikipedia membagi alat scraping menjadi dua kelompok besar: berbasis kode dan tanpa kode. Alat tanpa kode memakai antarmuka visual, sehingga pengguna cukup menandai bagian halaman yang ingin diambil. Wikipedia menyebut contoh alat komersial seperti Octoparse, Import.io, ParseHub, dan WebHarvy. Kelompok berbasis kode ditulis pengembang dengan bahasa pemrograman dan pustaka khusus untuk mengunduh serta mengurai halaman.
Untuk halaman yang isinya baru muncul setelah JavaScript berjalan, pengembang memakai otomasi browser seperti Selenium atau Playwright. Cara ini lebih berat karena setiap halaman dimuat lengkap seperti di browser biasa, tetapi hasilnya lebih mirip dengan yang dilihat pengunjung. Pilihan alat sebaiknya disesuaikan dengan jumlah data, seberapa sering data diperbarui, dan apakah ada jalur resmi yang lebih tepat.
Bagi pemilik usaha yang tidak menulis kode, alat tanpa kode sudah cukup untuk riset kecil. Untuk kebutuhan rutin dan berskala besar, biasanya dibutuhkan pengembang yang memahami etika scraping, misalnya memberi jeda antarpermintaan, menghormati robots.txt, dan berhenti saat server membalas tanda kelebihan beban.
Yang perlu dicatat, semua contoh di atas menyangkut data yang memang tampil untuk publik dan tidak menyasar data pribadi. Begitu data yang diambil berisi nama, nomor telepon, atau email orang, risikonya berubah, seperti dibahas di bagian berikutnya.
Batas etika dan hukum web scraping di Indonesia
Apakah web scraping legal? Jawabannya tergantung data apa yang diambil, bagaimana caranya, dan untuk apa dipakai. Wikipedia mencatat bahwa isu hukum web scraping berbeda antara Amerika Serikat, Uni Eropa, Australia, dan India, sehingga tidak ada jawaban yang berlaku sama di semua negara. Artikel ini bukan nasihat hukum. Untuk kasus nyata, konsultasikan dengan ahli hukum.
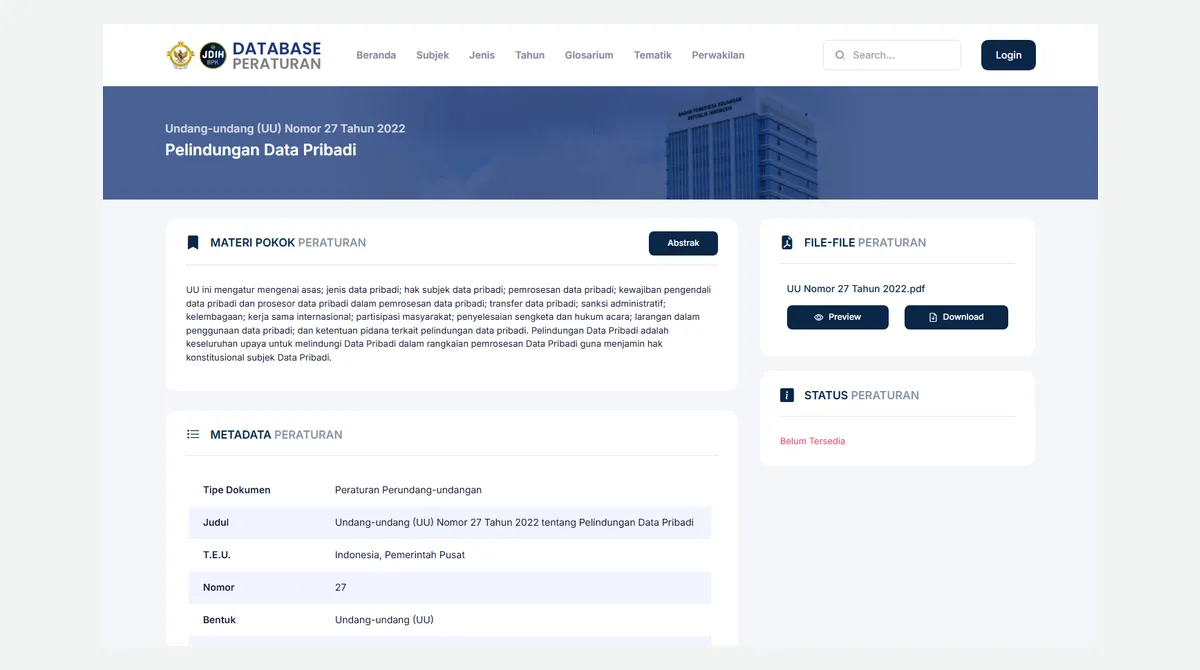
Di Indonesia, rujukan penting adalah UU Nomor 27 Tahun 2022 tentang Pelindungan Data Pribadi, yang ditetapkan dan berlaku sejak 17 Oktober 2022. Menurut ringkasan di basis data peraturan JDIH BPK, UU ini mengatur jenis data pribadi, hak subjek data pribadi, pemrosesan data pribadi, kewajiban pengendali dan prosesor data, larangan dalam penggunaan data pribadi, sampai ketentuan pidana.
Artinya, scraping yang mengumpulkan data pribadi orang lain, misalnya daftar nama dan nomor telepon dari direktori online, masuk wilayah berisiko walaupun datanya terlihat di halaman publik. Wikipedia menyebut praktik ini sebagai contact scraping. Selain soal hukum, ada juga pertimbangan etika dan syarat layanan situs sumber yang bisa melarang pengambilan data otomatis.
Beberapa pertanyaan yang bisa Anda ajukan sebelum memakai atau memesan scraper:
- Apakah data yang diambil berisi data pribadi orang lain?
- Apakah situs sumber menyediakan API resmi yang bisa dipakai?
- Apakah syarat layanan situs sumber melarang pengambilan data otomatis?
- Apakah kecepatan permintaan cukup pelan sehingga tidak membebani server orang lain?
- Apakah hasil scraping akan dipublikasikan ulang, atau hanya dipakai untuk analisis internal?
Peran robots.txt dan batasnya
Robots.txt adalah berkas teks di akar domain yang memberi tahu crawler bagian mana dari situs yang boleh diakses. Dokumentasi Google Search Central menyebut berkas ini terutama dipakai untuk menghindari server kelebihan permintaan, dan menegaskan bahwa robots.txt bukan mekanisme untuk menyembunyikan halaman dari Google. Untuk itu, Google menyarankan tag noindex atau perlindungan kata sandi.
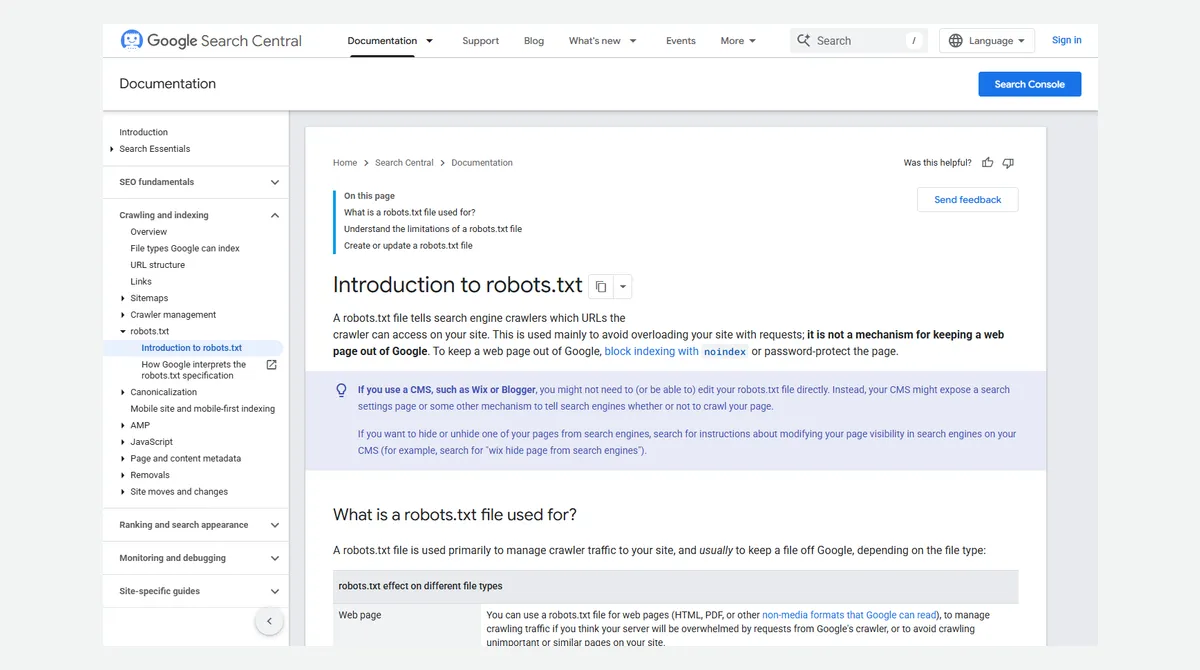
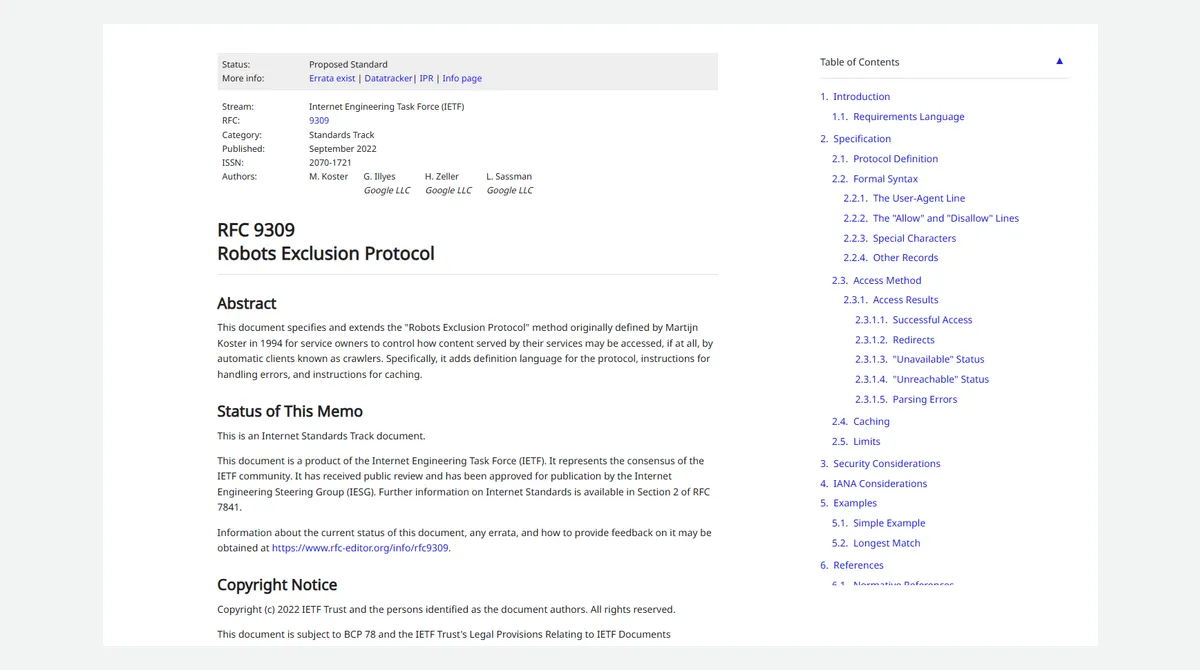
Dokumentasi yang sama menulis bahwa Googlebot dan crawler lain yang terpercaya mematuhi instruksi di robots.txt, tetapi crawler lain belum tentu. Standar resminya, RFC 9309 tentang Robots Exclusion Protocol yang terbit September 2022, bahkan menegaskan bahwa aturan robots.txt bukan bentuk otorisasi akses. RFC ini mencatat protokolnya pertama kali didefinisikan Martijn Koster pada 1994.
Jadi robots.txt tetap berguna sebagai rambu untuk bot yang sopan, termasuk mesin pencari. Namun jangan mengandalkannya untuk melindungi data. Halaman yang memuat informasi sensitif harus dilindungi login, bukan sekadar dilarang di robots.txt. Untuk situs WordPress, pengaturan akses di tingkat server juga bisa dibantu lewat berkas .htaccess.
Cara melindungi website Anda dari scraping berlebihan
Tidak semua bot perlu diblokir. Crawler mesin pencari justru Anda butuhkan agar halaman muncul di hasil pencarian. Yang perlu dicegah adalah bot yang meminta halaman terlalu sering sampai membebani server, atau yang mengambil data yang seharusnya tidak dibagikan.
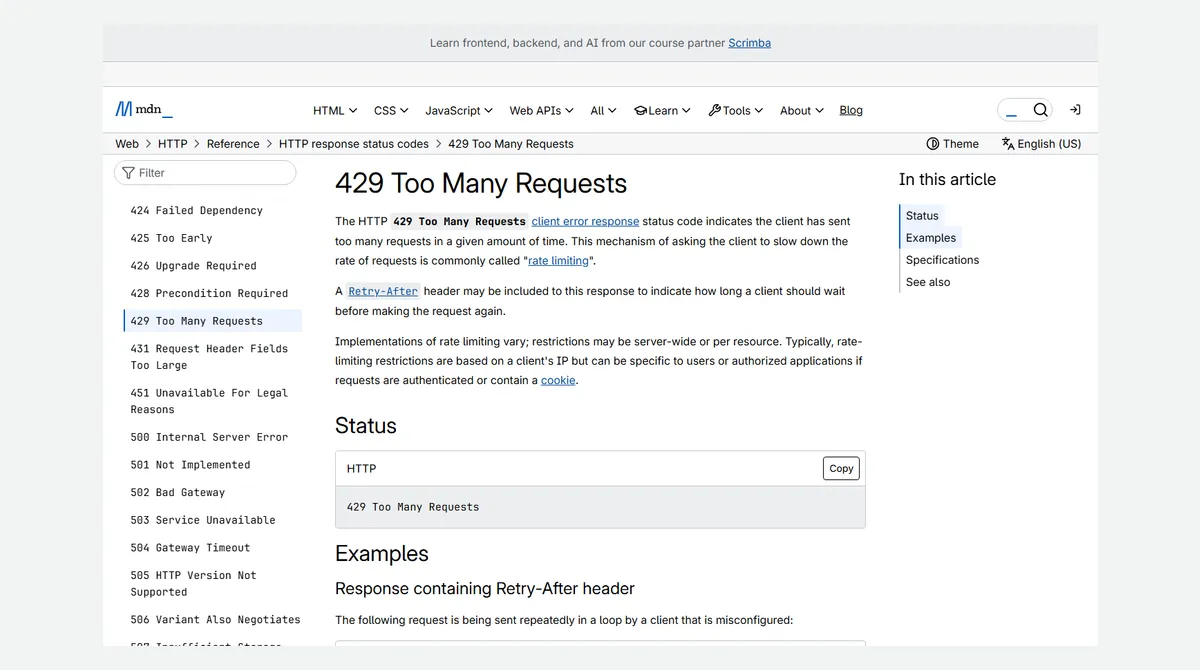
Salah satu lapisan terpenting adalah pembatasan jumlah permintaan atau rate limiting. Menurut MDN, kode status 429 Too Many Requests menandakan klien mengirim terlalu banyak permintaan dalam waktu tertentu. Server bisa menyertakan header Retry-After untuk memberi tahu berapa lama klien harus menunggu. Pembatasan ini biasanya berdasarkan alamat IP, tetapi bisa juga per pengguna atau per aplikasi.
Tabel ini lebih lebar dari layar. Geser ke samping untuk melihat seluruh kolom.
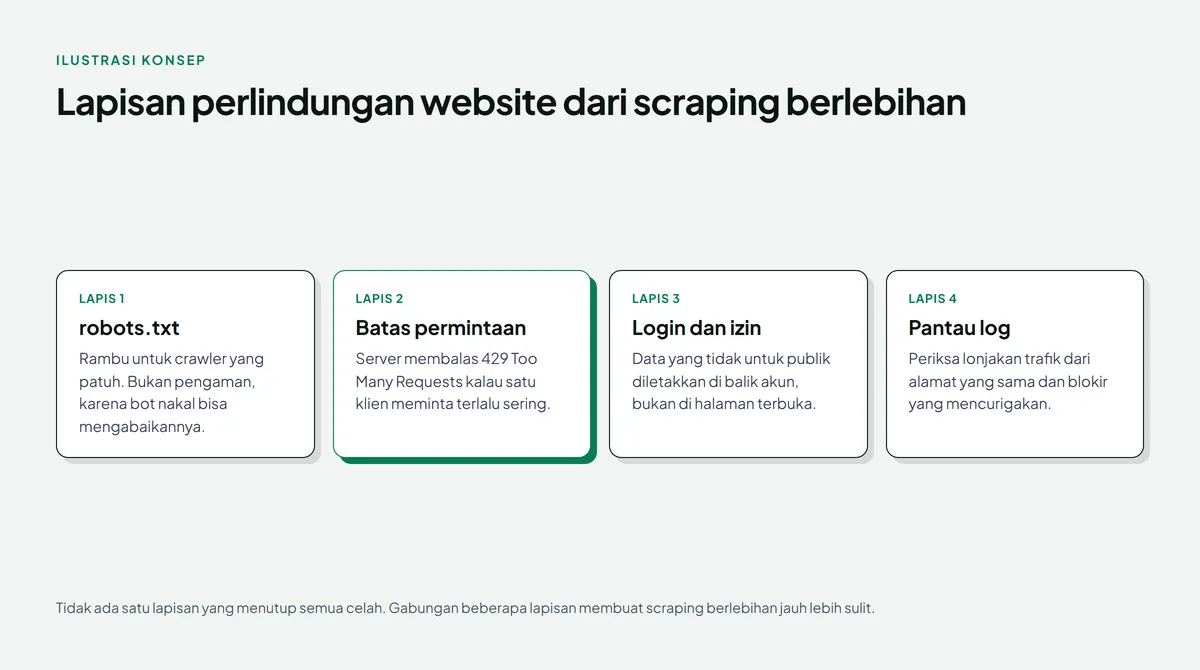
| Lapisan | Cara kerja | Yang dicegah | Batasnya |
|---|---|---|---|
| robots.txt | Memberi rambu bagian yang boleh dirayapi | Crawler patuh masuk ke area yang tidak perlu | Bot nakal bisa mengabaikannya |
| Rate limiting (429) | Membatasi jumlah permintaan per IP dalam waktu tertentu | Lonjakan permintaan yang membebani server | Scraper bisa memakai banyak alamat IP |
| Login dan izin akses | Data hanya tampil untuk pengguna yang berhak | Data sensitif terbaca publik | Tidak cocok untuk konten yang memang publik |
| Firewall aplikasi web | Menyaring permintaan berdasarkan pola bot | Bot yang dikenal berbahaya | Perlu disetel agar tidak memblokir pengunjung asli |
| Pemantauan log | Mencatat dan memeriksa pola trafik | Serangan yang tidak terdeteksi lapisan lain | Butuh waktu dan orang yang memeriksa |
Langkah praktis untuk pemilik usaha:
- Pastikan data yang tidak untuk publik, seperti daftar pelanggan atau dokumen internal, tidak pernah diletakkan di halaman terbuka.
- Minta pengelola hosting atau developer mengaktifkan pembatasan permintaan di server atau lewat layanan CDN.
- Periksa robots.txt agar tidak memblokir mesin pencari secara tidak sengaja.
- Pantau kecepatan situs. Penurunan mendadak tanpa penambahan pengunjung asli bisa menjadi tanda bot agresif. Cara mengukurnya ada di cara cek kecepatan website.
- Kalau memakai WordPress, gunakan plugin keamanan yang tepercaya. Pilihannya dibahas di artikel plugin WordPress.
Dampak scraping pada server dan hosting
Setiap permintaan dari scraper diproses server sama seperti permintaan dari pengunjung asli. Server harus membaca berkas, menjalankan kode, dan sering kali mengakses basis data. Kalau scraper mengirim ratusan permintaan per menit, sumber daya yang seharusnya melayani pelanggan ikut terpakai.
Dampaknya paling terasa di hosting dengan sumber daya terbatas. Halaman bisa melambat, dan pada kasus berat situs sulit diakses. Pemahaman tentang peran server membantu Anda membaca gejala seperti ini. Baca penjelasan web server adalah dan perbedaan jenis layanan di apa itu hosting dan domain.
Situs toko online dengan ribuan halaman produk termasuk sasaran yang sering dirayapi, karena datanya bernilai untuk perbandingan harga. Saat merencanakan website seperti ini, sebaiknya bahas sejak awal dengan developer soal pembatasan permintaan, caching, dan pemantauan log. Gambaran peran developer ada di artikel web developer adalah.
Kesalahan umum soal web scraping
Anggapan: data yang terlihat publik bebas diambil untuk apa saja. Fakta: data publik bisa tetap berisi data pribadi yang dilindungi UU PDP, dan situs sumber bisa punya syarat layanan sendiri.
Anggapan: robots.txt sudah cukup melindungi website. Fakta: Google dan RFC 9309 sama-sama menegaskan robots.txt hanya rambu bagi crawler yang patuh, bukan otorisasi akses.
Anggapan: semua bot harus diblokir. Fakta: crawler mesin pencari dibutuhkan agar halaman Anda muncul di Google. Memblokir semua bot justru merugikan visibilitas situs.
Anggapan: scraping selalu lebih mudah daripada API. Fakta: scraper mudah rusak saat tampilan situs sumber berubah. Kalau ada API resmi, jalur itu biasanya lebih stabil dan jelas izinnya.
Kesimpulan
Web scraping adalah pengambilan data dari website secara otomatis. Teknik ini berguna untuk riset pasar, pemantauan harga, dan pemeriksaan website sendiri, tetapi punya batas etika dan hukum, terutama bila menyentuh data pribadi yang diatur UU Nomor 27 Tahun 2022.
Sebagai pemilik website, Anda tidak perlu takut pada semua bot. Pastikan data sensitif tidak tampil di halaman publik, aktifkan pembatasan permintaan, periksa robots.txt, dan pantau kecepatan situs. Kalau Anda sedang merencanakan website baru, mulai dari dasar di website adalah dan rencanakan keamanannya sejak awal.